


 رک شبکه


 خدمات VOIP


شبکه Scale-up چیست؟ بررسی NVLink 6 در دیتاسنترهای هوش مصنوعی

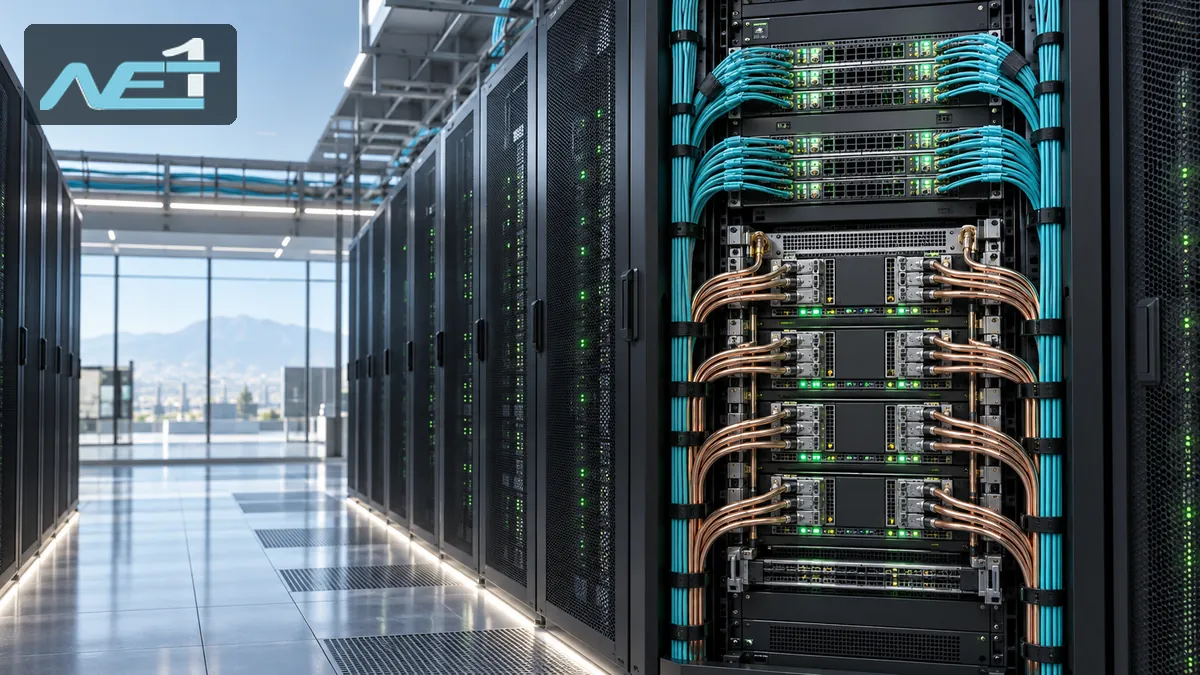
پاسخ کوتاه: شبکه Scale-up نوعی اتصال فوقسریع و کمتاخیر میان شتابدهندههای یک دامنه محاسباتی است تا چند GPU مانند یک موتور پردازشی واحد کار کنند. NVLink 6 نمونهای اختصاصی از این معماری برای رکهای هوش مصنوعی NVIDIA است و جای شبکه Scale-out مبتنی بر Ethernet یا InfiniBand را نمیگیرد؛ این دو لایه باید در کنار هم طراحی شوند.
شبکه Scale-up چیست و چرا برای هوش مصنوعی مهم شده است؟
در آموزش و استنتاج مدلهای بزرگ، سرعت خام هر GPU تنها بخشی از مسئله است. مدلهایی مانند Mixture of Experts داده و توکن را پیوسته میان چند شتابدهنده جابهجا میکنند. اگر ارتباط GPU به GPU پهنای باند کافی یا تاخیر قابل پیشبینی نداشته باشد، بخشی از توان محاسباتی گرانقیمت در انتظار تبادل داده میماند.
شبکه Scale-up این ارتباط نزدیک را داخل یک دامنه محاسباتی برقرار میکند. هدف آن افزایش تعداد کاربران شبکه نیست؛ هدف این است که شتابدهندهها به حافظه و دادههای یکدیگر سریعتر دسترسی داشته باشند و عملیات جمعی مانند All-Reduce با سربار کمتر انجام شود.
NVLink 6 چه مشخصاتی ارائه میکند؟
طبق مشخصات منتشرشده در وبلاگ فنی NVIDIA، نسل ششم NVLink در سامانه Vera Rubin NVL72 پهنای باند دوطرفه ۳.۶ ترابایتبرثانیه برای هر GPU و در مجموع ۲۶۰ ترابایتبرثانیه در سطح رک فراهم میکند. این معماری ۷۲ GPU را در یک توپولوژی All-to-All به هم متصل میکند و برای عملیات درونشبکهای نیز توان محاسباتی اعلامشده ۱۳۰ ترافلاپس دارد.
این اعداد مشخصات یک پلتفرم یکپارچه و اختصاصی هستند، نه نتیجهای که با افزودن یک سوئیچ معمولی به هر سرور به دست آید. عملکرد واقعی نیز به نوع بار کاری، نرمافزار، چیدمان رک، کیفیت کابلکشی، توان، خنکسازی و سیاستهای زمانبندی وابسته است.
تفاوت Scale-up و Scale-out در دیتاسنتر چیست؟
| معیار | Scale-up | Scale-out |
|---|---|---|
| هدف اصلی | یکپارچهکردن شتابدهندهها در یک دامنه محاسباتی | اتصال تعداد زیادی سرور، رک یا سایت |
| اولویت فنی | تاخیر بسیار کم و پهنای باند GPU به GPU | مقیاسپذیری، مسیریابی و اتصال سراسری |
| نمونه فناوری | NVIDIA NVLink | Ethernet، Spectrum-X یا InfiniBand |
| دامنه کاربرد | داخل رک یا دامنه نزدیک پردازشی | میان سرورها، رکها و خوشهها |
بنابراین انتخاب میان این دو یک تصمیم صفر و یک نیست. دیتاسنتر هوش مصنوعی برای ارتباط نزدیک شتابدهندهها به Scale-up و برای اتصال رکها، ذخیرهسازی، مدیریت و دسترسی کاربران به Scale-out نیاز دارد.
در عمل، طراحی شبکه Scale-up باید همراه با نقشه ظرفیت، سناریوی خرابی و آزمون بار واقعی انجام شود؛ عدد پهنای باند اسمی بهتنهایی معیار کافی برای خرید نیست.
پیش از خرید زیرساخت هوش مصنوعی چه چیزهایی را ارزیابی کنیم؟
۱. بار کاری واقعی و الگوی ترافیک
مدل، اندازه Batch، روش Parallelism و حجم تبادل میان GPUها را اندازهگیری کنید. خرید گرانترین Fabric بدون پروفایل بار کاری میتواند هزینه را بالا ببرد، بیآنکه گلوگاه اصلی را برطرف کند.
۲. قابلیت سرویس و تابآوری
خرابی یک لینک یا Switch Tray نباید کل رک را متوقف کند. مسیر جایگزین، تعویض گرم، تلهمتری سطح لینک، بهروزرسانی حین سرویس و روش عیبیابی باید پیش از خرید در سناریوی عملی بررسی شوند.
۳. توان، خنکسازی و کابلکشی
رک هوش مصنوعی فقط مجموعهای از سرورها نیست. ظرفیت برق، دفع حرارت، وزن رک، مسیر کابل و فضای سرویس به اندازه توان محاسباتی اهمیت دارند. این محدودیتها در بسیاری از دیتاسنترهای موجود، زودتر از ظرفیت GPU به سقف میرسند.
۴. بلوغ نرمافزار و قفلشدن به فروشنده
در NVLink، سختافزار و نرمافزار بهصورت یکپارچه طراحی شدهاند. این موضوع میتواند عملکرد و پایداری را بهتر کند، اما هزینه مهاجرت و وابستگی به اکوسیستم را نیز افزایش میدهد. سازگاری با فریمورکها، ابزارهای مانیتورینگ و برنامه توسعه سهساله سازمان را بررسی کنید.
این معماری چه ارتباطی با شبکه سازمانی دارد؟
حتی اگر سازمان هنوز به رک NVLink نیاز نداشته باشد، جداسازی لایه دسترسی، شبکه مدیریتی، ذخیرهسازی و ترافیک محاسباتی یک اصل مفید است. برای طراحی بخشهای متعارف شبکه میتوانید مشخصات سوئیچهای شبکه را بر اساس ظرفیت Uplink، قابلیت مدیریت، افزونگی و پشتیبانی از فیبر مقایسه کنید.
در لایه محاسبات سازمانی نیز انتخاب شاسی، پردازنده، حافظه، کارت شبکه و منبع تغذیه باید بر اساس بار کاری انجام شود. صفحه سرورهای HPE میتواند برای بررسی گزینههای زیرساخت عمومی استفاده شود؛ با این توضیح مهم که هر سرور HPE لزوماً از NVLink 6 یا معماری Vera Rubin پشتیبانی نمیکند و سازگاری باید در دیتاشیت رسمی همان پلتفرم تایید شود.
آیا NVLink 6 برای همه شرکتها انتخاب مناسبی است؟
خیر. برای مجازیسازی، فایلسرور، تلفن سازمانی، پایگاه دادههای معمول و بسیاری از بارهای هوش مصنوعی کوچک، شبکه Ethernet استاندارد و یک سرور متناسب اقتصادیتر و سادهتر است. NVLink 6 زمانی معنا پیدا میکند که هزینه انتظار GPU، زمان آموزش یا تاخیر استنتاج در مقیاس رک از هزینه پلتفرم یکپارچه بیشتر باشد.
پرسشهای متداول
آیا NVLink جای Ethernet را میگیرد؟
خیر. NVLink ارتباط Scale-up میان شتابدهندهها را هدف میگیرد، درحالیکه Ethernet همچنان برای اتصال سرورهای مدیریت، ذخیرهسازی و شبکه گسترده دیتاسنتر ضروری است.
آیا میتوان NVLink 6 را به هر سروری اضافه کرد؟
خیر. این فناوری به پلتفرم، شتابدهنده، Switch Tray، توپولوژی و نرمافزار سازگار نیاز دارد و مانند یک کارت شبکه عمومی قابل افزودن به هر سرور نیست.
مهمترین معیار ارزیابی شبکه هوش مصنوعی چیست؟
بهجای تکیه بر یک عدد، عملکرد تحویلی زیر بار واقعی، تاخیر پایدار، تابآوری، مصرف انرژی، قابلیت سرویس و هزینه کل مالکیت را با هم مقایسه کنید.
جمعبندی
شبکه Scale-up به یکی از تصمیمهای کلیدی در طراحی دیتاسنتر هوش مصنوعی تبدیل شده است، زیرا بازده GPUها را مستقیماً تحت تاثیر قرار میدهد. NVLink 6 نمونهای پرقدرت از این رویکرد است، اما انتخاب آن باید بر مبنای اندازه مدل، الگوی ارتباط، ظرفیت برق و خنکسازی، ریسک وابستگی و هزینه کل مالکیت انجام شود. برای بیشتر سازمانها، نخستین گام درست اندازهگیری بار کاری و طراحی دقیق لایه Scale-out است، نه خرید شتابزده یک پلتفرم رکمقیاس.
منبع
NVIDIA Technical Blog، مقاله NVIDIA NVLink: The Scale-Up Network for AI Factories؛ مطالعه مقاله اصلی در NVIDIA Technical Blog.